Die fehlerhafte Einstufung der digitalen Urheberschaft
Warum man manchen KI-Detektoren nicht trauen kann | Die Authors Guild hat fünf davon auf den Prüfstand gestellt
Da sich generative künstliche Intelligenz von einer experimentellen Neuheit zum Brainstorming zu einem im industriellen Maßstab einsetzbaren Werkzeug wandelt, das in der Lage ist, ganze Manuskripte zu produzieren, ist das Verlagswesen in einen Zustand tiefgreifender Paranoia gestürzt worden. Angetrieben von der Angst vor automatisiertem Plagiat, einer Übersättigung des Marktes und der Erzeugung synthetischer Texte wenden sich Verlage, Literaturagenten und Preisjurys zunehmend algorithmischen „Gatekeepern“ zu. Ein informeller interner Test der Authors Guild zeigt jedoch, dass diese Diagnosetools ein ernstzunehmendes Risiko mit sich bringen können: die systematische falsche Beschuldigung menschlicher Urheber.
Veröffentlicht: 12.6.2026 | Foto / Video: KI-generiert, Magnific
Die Ängste, die die Branche plagen, sind nicht unbegründet. Aufsehenerregende Skandale haben gezeigt, wie schnell generative Modelle die literarische Integrität untergraben können. Kürzlich deckte die „New York Times“ auf, dass Steven Rosenbaums Sachbuch „The Future of Truth“ – ironischerweise eine Untersuchung über die technologische Aushöhlung der Realität – mehr als ein halbes Dutzend erfundene oder falsch zugeordnete, von KI generierte Zitate enthielt. Rosenbaum räumte die Fehler ein, bezeichnete sie als versehentlich und erklärte, er habe eigene Untersuchungen eingeleitet. Gleichzeitig werden Literaturwettbewerbe mit automatisierten Einsendungen überschwemmt.
Die Kontroverse erreichte ihren Höhepunkt beim Commonwealth Short Story Prize 2026, wo einer der Gewinnerbeiträge, „The Serpent in the Grove“ von Jamir Nazir (veröffentlicht in Granta), von der Erkennungssoftware Pangram als zu 100 Prozent KI-generiert markiert wurde. Granta ließ die Geschichte bis zum Vorliegen endgültiger Beweise online, räumte jedoch ein, dass nicht mit Sicherheit gesagt werden könne, dass das Werk von einem Menschen verfasst worden sei, und die Commonwealth Foundation verteidigte ihr Vorgehen, erklärte aber, sie werde ihr Auswahlverfahren überprüfen. Beide wiesen darauf hin, dass KI-Detektoren unvollkommen seien.
Es steht in beiden Richtungen viel auf dem Spiel. Ein falsch positives Ergebnis kann einen Autor seinen Verlagsvertrag und seinen Ruf kosten, während ein falsch negatives Ergebnis – also wenn KI-Ergebnisse unentdeckt durchrutschen – dazu führen kann, dass Leser das Vertrauen in Autoren und die Branche verlieren. Dies schafft ein Umfeld, das an historische Hexenjagden erinnert, in dem Autoren berichten, dass sie aus Angst vor falschen Anschuldigungen ihren natürlichen Schreibstil ändern.
Die Authors Guild hat einen informellen Test gestartet, um die Gatekeeper auf die Probe zu stellen
Um festzustellen, ob handelsübliche KI-Detektoren technisch in der Lage sind, menschliche Prosa zuverlässig von maschinengenerierten Texten zu unterscheiden, Die Authors Guild führte einen informellen Test durch. Darin wurden fünf bekannte Erkennungsplattformen behandelt: ZeroGPT, Originality.ai, Sidekicker.ai, Grammarly und Pangram.
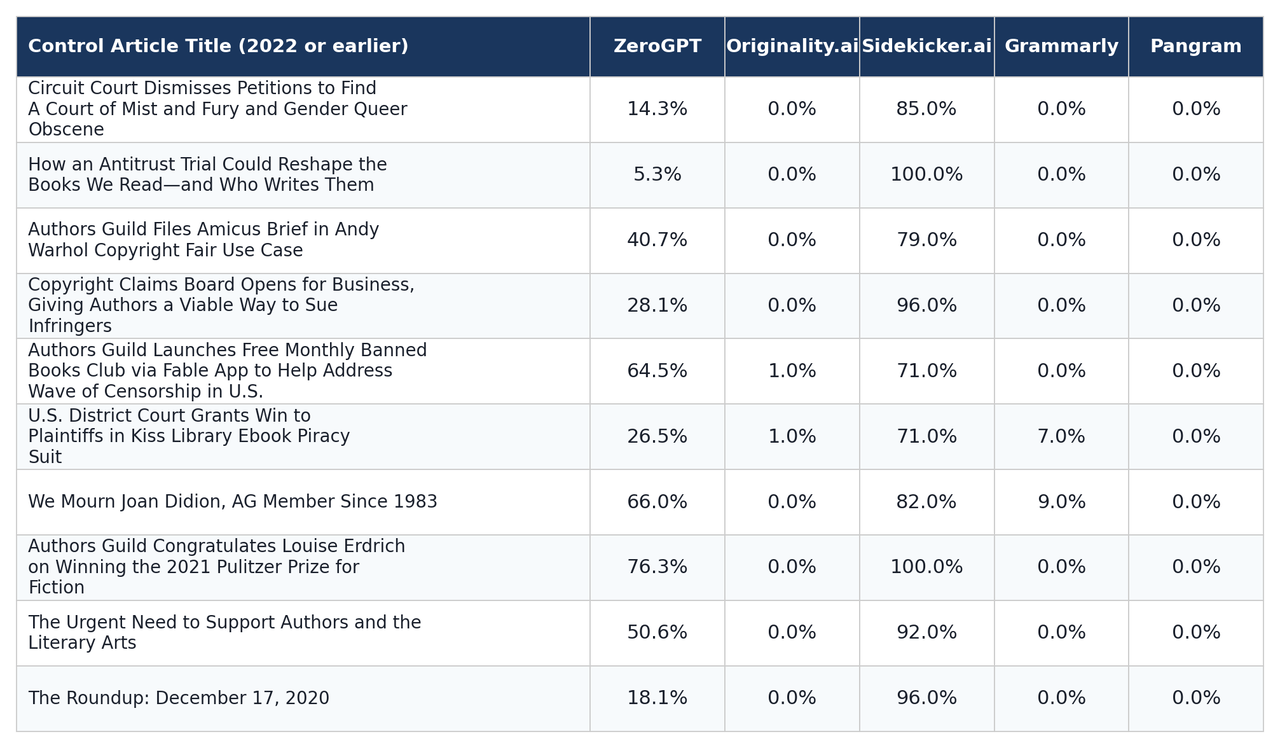
Die Kontrolldaten bestanden aus zehn authentischen Artikeln der Authors Guild. Entscheidend ist, dass alle ausgewählten Texte im Jahr 2022 oder früher verfasst und veröffentlicht wurden – also deutlich vor der kommerziellen Einführung und der weit verbreiteten Nutzung von großen Sprachmodellen (LLMs) für Endverbraucher. Da diese Texte per Definition vollständig von Menschen verfasst wurden, sollte jedes präzise Tool durchweg einen niedrigen KI-Erkennungswert liefern.
Empirische Erkenntnisse zeigen ein erschreckendes Ausmaß an Unzuverlässigkeit
Die daraus resultierenden Daten zeigten enorme Unterschiede zwischen den einzelnen Softwareprogrammen, die von absoluter technischer Genauigkeit bis hin zu katastrophalen systematischen Fehlern reichten. Die Prozentangaben geben den Anteil des Textes wieder, der in den historischen Kontrollartikeln als von einer KI verfasst markiert wurde:
Die Softwareleistung lässt sich in drei verschiedene Ebenen unterteilen
Der bewährte Standard (Pangram & Originality.ai): Pangram zeigte eine einwandfreie Ausführung und erzielte in allen zehn Testfällen einen AI-Wahrscheinlichkeitswert von 0,0 %. Originality.ai Es behielt eine hohe Genauigkeit bei und erzielte bei acht Aufsätzen einen Wert von 0,0 % sowie bei den verbleibenden zwei einen vernachlässigbaren Wert von 1,0 %. Grammarly lag dicht dahinter und hielt die Abweichungen unter 10 % – ein Wert, der so niedrig ist, dass keiner der beiden Werte in der Praxis wahrscheinlich Anlass zur Sorge geben würde.
Die unbeständige Gefahr (ZeroGPT): ZeroGPT zeigte erhebliche Instabilität. Seine Werte schwankten unvorhersehbar zwischen 5,3 % und einem gefährlich hohen Wert von 76,3 %. Erstaunlicherweise wurde ein sehr emotionaler Text – der Nachruf auf die Literaturikone Joan Didion – zu 66,0 % als maschinell verfasst eingestuft, während ein feierlicher Beitrag zu Louise Erdrichs Pulitzer-Preis einen AI-Anteil von 76,3 % aufwies. Das völlige Fehlen struktureller Vorhersehbarkeit bei ZeroGPT macht es zu einer unberechenbaren Bedrohung für Autoren.
Das Versagen der Konstruktion (Sidekicker.ai): Sidekicker.ai Dies führte zu katastrophalen Ergebnissen. Es stufte jedes einzelne historische Dokument als überwiegend KI-generiert ein, wobei die Werte von 71,0 % bis zu zwei eindeutigen Fehlalarmen von 100,0 % reichten. Ein Software-Tool, das nicht in der Lage ist, einen im Jahr 2020 verfassten menschlichen Text von einem modernen Maschinenalgorithmus zu unterscheiden, stellt einen vollständigen systemischen Zusammenbruch dar.
Das stilistische Paradoxon bestraft meisterhaftes Handwerk
Die eigentliche Ursache dieser Fehler liegt in der Funktionsweise von KI-Detektoren. Diese Tools sind darauf ausgelegt, statistische Indikatoren zu analysieren: Satzrhythmus, Wortverteilung und Vorhersehbarkeit des Textes.
Ironischerweise spiegelt eine ausgefeilte, disziplinierte und prägnant formulierte Prosa genau diese Muster wider. Da große Sprachmodelle auf ausgefeilter, überarbeiteter Prosa trainiert wurden, die von erfahrenen menschlichen Autoren verfasst wurde, kann es sein, dass ein professioneller Autor, der sein ganzes Leben damit verbracht hat, Klarheit und Prägnanz zu perfektionieren, per Definition auf eine Weise schreibt, die sich mit dem überschneidet, was diese Tools erkennen sollen. Die Software kann nicht zwischen einem menschlichen Autor, der sein Handwerk beherrscht, und einer Maschine, die gelernt hat, es nachzuahmen, unterscheiden.
Die Authors Guild gibt rechtliche und politische Leitlinien für die Verlagsbranche heraus
Die Ergebnisse dieser Studie zeigen, dass es äußerst gefährlich ist, unüberprüfte, für Verbraucher bestimmte Erkennungsinstrumente zu nutzen, um weitreichende Entscheidungen in Bezug auf Anstellungen oder Verträge zu treffen. Die Authors Guild warnt davor, dass Verlage den Vertrag eines Autors niemals einseitig kündigen oder ein Manuskript zurückziehen sollten, wenn sie sich dabei ausschließlich auf automatisierte KI-Vorwürfe stützen. Ein solches Vorgehen allein auf der Grundlage dieser Tools oder Vorwürfe würde einen wesentlichen Vertragsbruch darstellen.
In Zukunft muss die Branche transparente Überprüfungsverfahren einführen, die den beschuldigten Autoren ein umfassendes Recht auf Verteidigung gewähren. Die Authors Guild hat erklärt, dass sie diese Fragen eingehend prüft, weitere Empfehlungen aussprechen wird und jedem Mitglied, das zu Unrecht des Einsatzes von KI beschuldigt wurde, rechtliche Unterstützung anbietet.